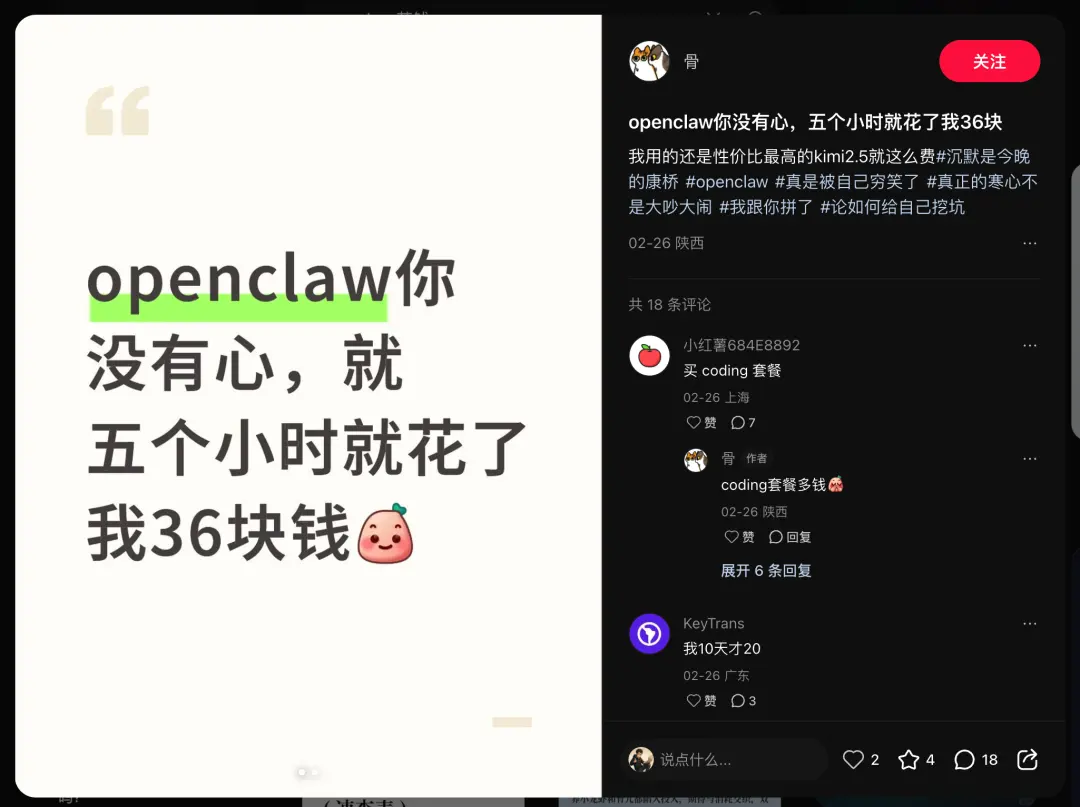
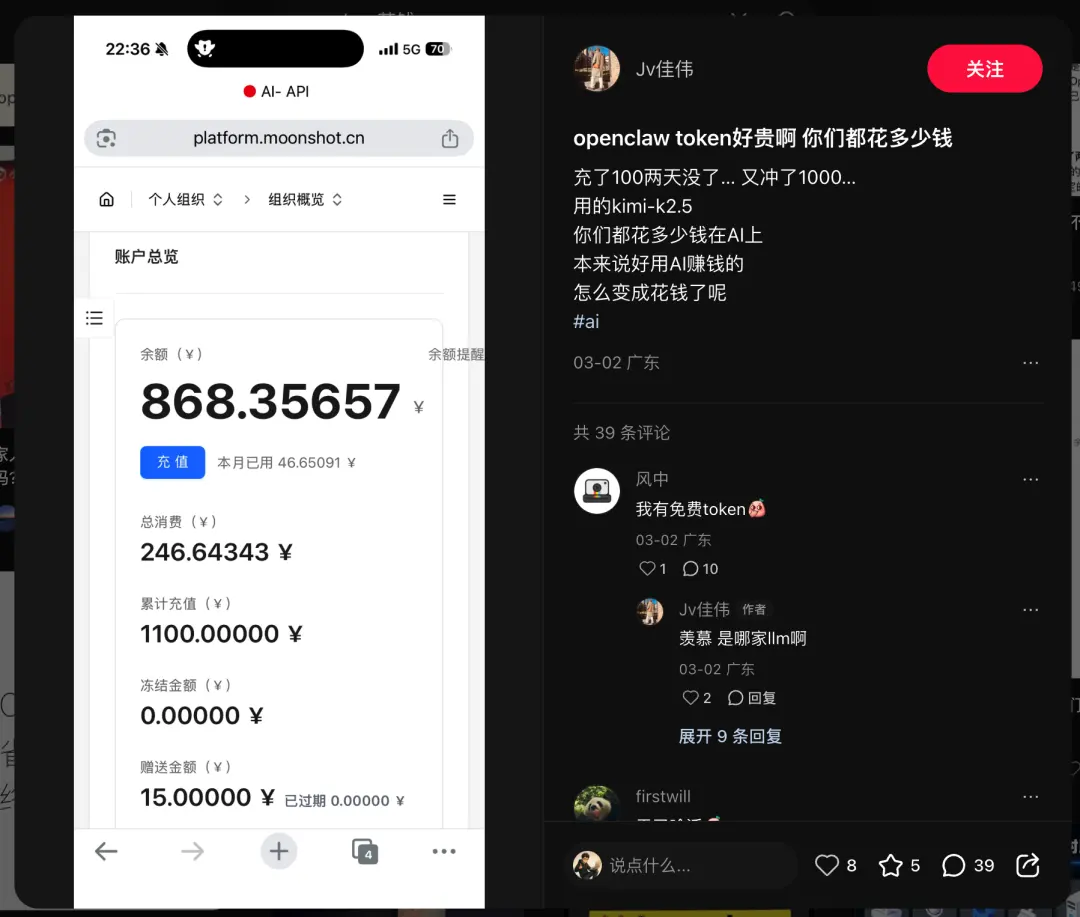
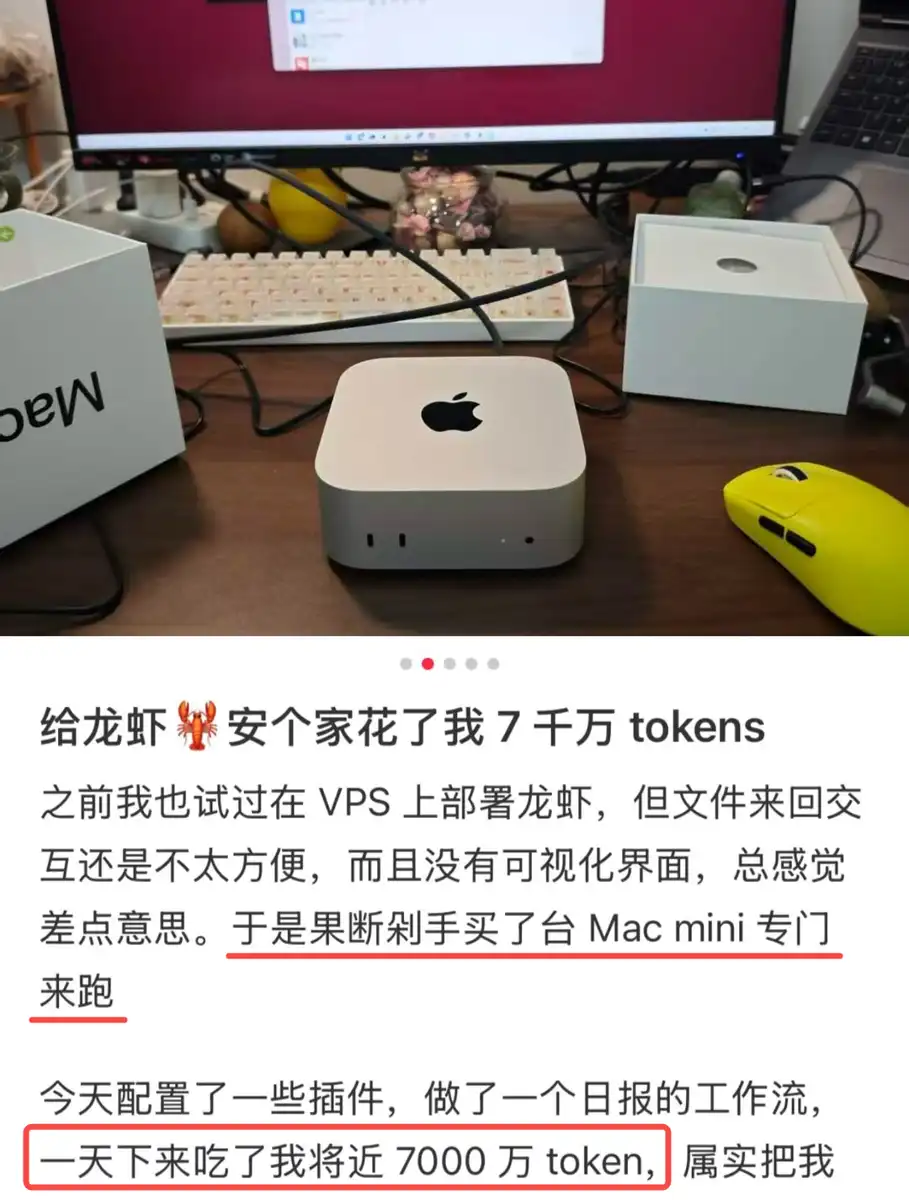
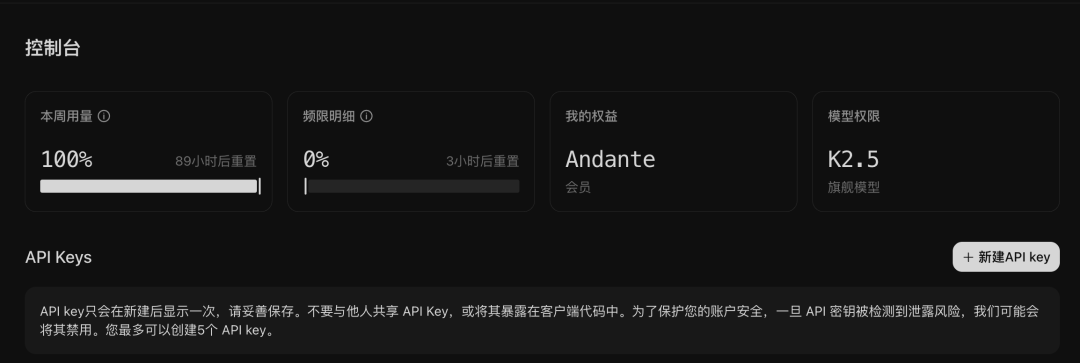
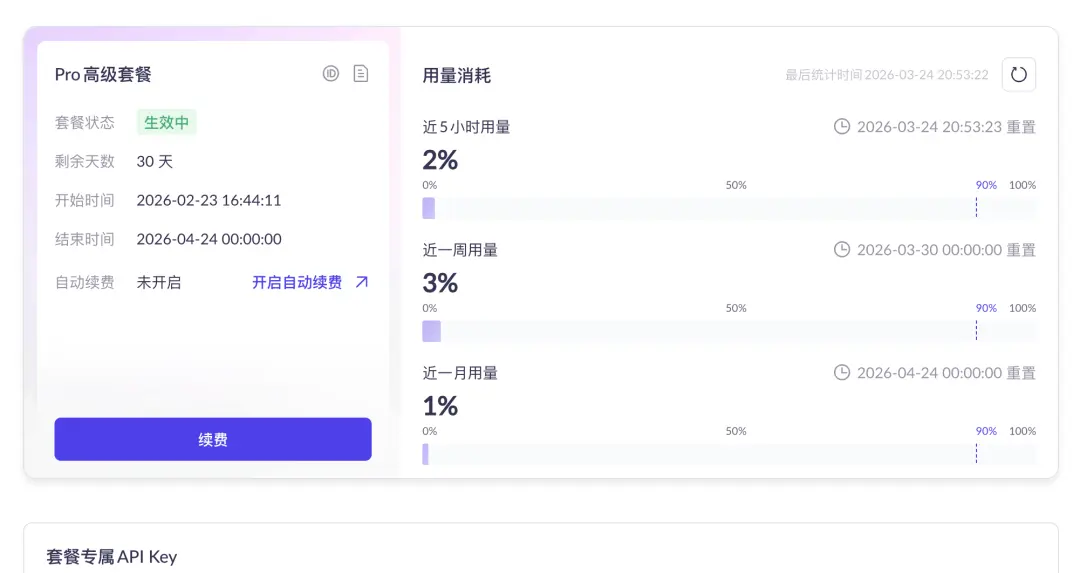
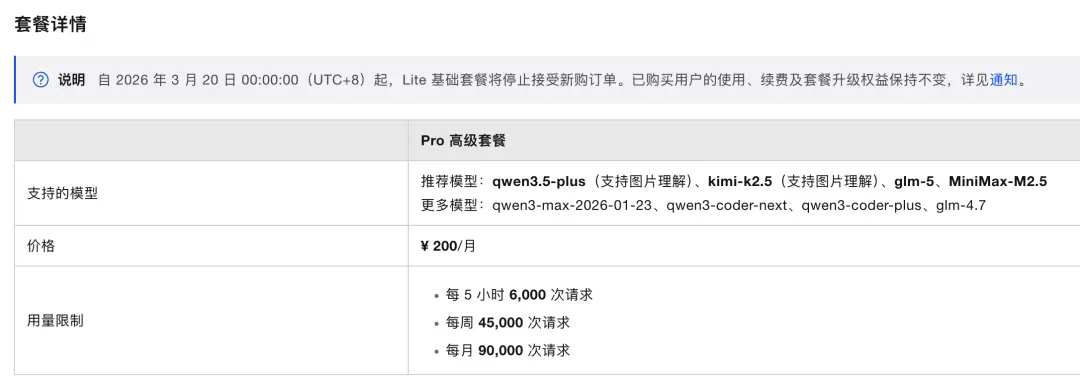
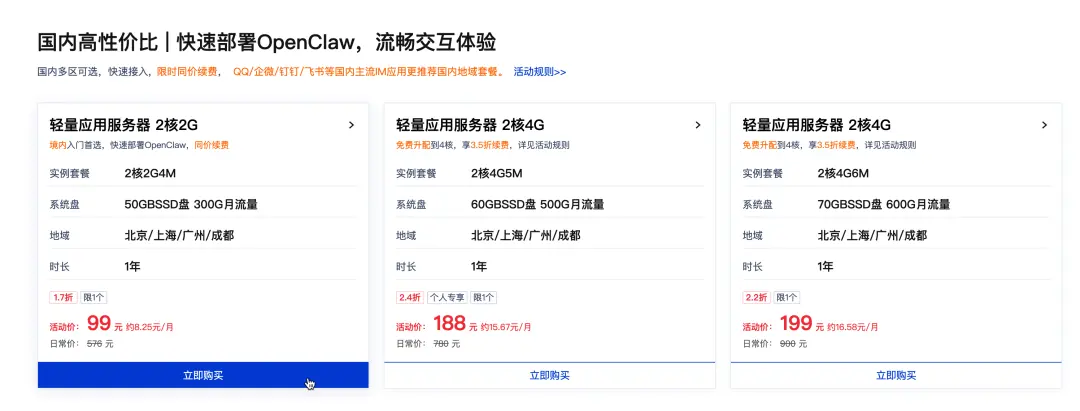
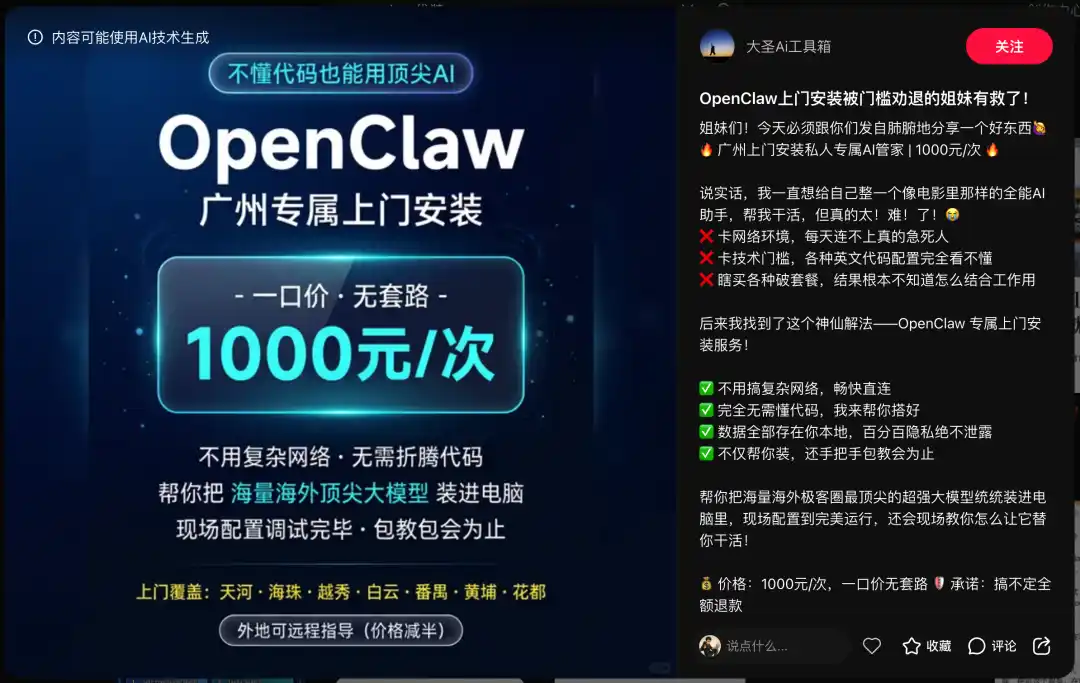
春节后开始上班,OpenClaw 这个有记忆的、能自主运行的 AI 彻底引爆了大众的神经,大厂也好、个人也好,纷纷下场开始「养龙虾」,甚至连安装都爆出了 500 甚至上千的高价。 但半个月过去,第一批开始养龙虾的人纷纷发现不对:为什么感觉没做什么事,账单却越来越多了呢?有人几十、数百能把小龙虾养得很好,而有的人却各种欠费、动辄上千,到底差在哪里? 这篇文章,我来和大家聊一下 OpenClaw 的费用计算问题。你看完能知道三件事: 钱花在哪里、为什么一开始便宜后来变贵、怎么控制住「漏水」 。 这里的 OpenClaw 只是 AI 工具的一个代表,其他包括 Claude Code 或者我们连接 API 使用的 Cherry Studio 之类的,算法都是一样的。 既然我们都知道 OpenClaw 是个 AI 产品,那么肯定是需要付费使用的。 AI 费用的计量单位是 Token(词元) 。它是 AI 用来计算「读了多少东西」和「写了多少东西」的最小单位。你给 AI 的任务越重,AI 回复的内容越多,消耗的 Token 就越多,这就相当于你花的「话费」越多。 汉字: 通常一个汉字要占 1 到 2 个 Token 英文: 一个长单词可能被拆成 2 个 Token,短单词占 1 个 标点符号: 通常各占 1 个 Token,如果是连续的符号(比如!!!),每个符号单独算一个,空格也算 比如我们打招呼说的「你好」,英文是「Hello」,中英文各占 2 个 Token。 而各个 AI 常用的「百万 Token」的计量,大致相当于一套《三体》全集,或《指环王》三部曲的单词量。 总费用 =(输入 Token × 输入单价)+(输出 Token × 输出单价) OpenClaw 本身的设定文件,比如改造过的 USER.md、MEMORY.md 文件等 对 OpenClaw 说的话,哪怕是「你好」这种打招呼,甚至一个「?」也算 上传给 OpenClaw 的文件,比如截图、doc 这种办公文件 OpenClaw 抓取的网页内容、读取的代码、读取的文件内容 和 OpenClaw 聊天的历史记录,只要没展开新的话题,就一直带着前面聊天的内容进行对话 你和 OpenClaw 开始一个新对话,这时候历史记录为 0,就像一张白纸。你问一句,它答一句,速度最快,几乎不费力气。 但如果你和 AI 聊了 100 次对话,让它读了网页、看了文件、还写了代码;这些内容就是一本越写越厚的 「历史记录」 ,即便这个历史记录会被压缩,但只要你不「开启新话题」,AI 每次开口前,都必须先把这本历史记录从头到尾 快速过一遍 ,确认一下之前聊过什么,然后再回答你——这就是导致回复变慢、消耗的 Token 也成倍增加的罪魁祸首,除非展开新的话题。 你说一句话: 相当于发了一条 极短的短信 ,不到 100 个 Token。 AI 做这件事: 相当于每 5 分钟让它去翻一本 5 到 10 页的小册子 ,然后告诉你结果。 这里还有一个陷阱:如果你是在一个已经聊了很久(历史记录很长)的对话框里发这句话,那么 AI 每次监控时,不仅要算这 2000 Token 的任务费,还要加上你之前聊过的所有「历史包袱」。 ——这就是为什么「5 小时 36 元」会发生,也是为什么「100 元两天没了」会发生。每一笔看起来都不大,但叠在一起就是流量泄洪。 简单理解就是 OpenClaw 给你的回复,包括写的代码、整理过的内容、总结、提醒等所有结果 。 因此,我们可能只输入了一句很短的提示词,但最终真实参与推理的 Token 可能高达数万。并且随着对话轮次增加,大模型输出的内容也会加入到上下文中给到大模型进行下一轮输出,跟滚雪球一样,上下文体积越滚越大。 「帮我监控贵州茅台这只股票,每 5 分钟关注一次价格,如果发生变化,发邮件通知我」 读取指令 + 历史记录 : 指令约 60 Token,加上系统提示词、用户提示词等约 300+ Token (如果你在旧对话里发,可能更多)抓取网页数据(输入) : AI 去看一眼「贵州茅台」实时行情,抓取到的网页数据或搜索结果,大约会占用 500 到 2000 Token (取决于网页的复杂度)判断并输出 : AI 对比价格后,如果没变化,可能只输出一个静默信号;如果发邮件,回复内容大约 100 Token单次监控: 大约消耗 1000 到 2000 Token 全天交易时段(4 小时): 约 10 万 Token 如果你把频率设成 5 分钟一次,一天 288 次;如果设成 1 小时一次,一天 24 次。 同一个任务,频率决定了账单的天花板。 你也可以用「单次成本」来判断。比如每次监控大概 1000 Token,5 分钟一次就是 28.8 万 Token/天;1 小时一次就是 2.4 万 Token/天。数字本身不是重点,重点是你能直观看到: 频率一改,量级就变了。 这个案例解释了我们在使用 OpenClaw 的过程中费用如何计算的问题: 你把任务设成「5 分钟一次」,它就一直跑;你把任务设成「1 小时一次」,成本会直接降一个量级。 频率是最直接、最粗暴的成本开关。你以为自己是「多抓点数据更稳」,实际上是在用 12 倍的频率去买一模一样的结果。 你让它记住品牌风格、客户名单、历史素材,输入 Token 会越来越大。你会看到「前几天便宜,一周后变贵」,不是模型涨价,而是你喂进去的上下文越来越重。 最常见的误区是:把一堆历史素材直接塞进系统提示词里。久而久之,每次运行都在为「历史包袱」付费。 你不是只在聊天。你让它抓网页、整理、生成、回写、再通知,每一步都在计费。 运营类任务贵,不是因为单步贵,而是因为链条长。你以为是一件事,其实是 6 到 8 件事连起来跑,成本自然像「多开了几个水龙头」。 频率拉高、上下文变重、工具链变长,账单会像「漏水」。 不是所有的模型都是这样的,有一些也有特别的收费方式: 这种套餐是按照用量计费的(也是 Token 的算法),但为了避免大家睡一觉后房子归大模型厂商的离谱事件发生,有做用量限制。当用量达到上限时,API 会无法使用(会有各种报错提示),然后控制台显示 100%,一般是 5 小时内,到下一个时间点恢复。 有些平台还会在 5 小时之外增加周用量的限制,达到周用量了,就要等到下周更新才能继续使用。 这种套餐是按照触发次数计算。也就是不管你一次发了多少 Token,用了多少提示词,都是算一次。但工具调用、系统提示词这些也算。所以并不是一次对话算一次,而是一次对话可能会有十几次。 额度消耗: 单次提问将按实际「模型调用次数」扣除额度。简单任务约消耗 5-10 次,复杂任务约 10-30+ 次,实际消耗受任务难度、上下文及工具使用影响。 如果是本地部署,很多人会买一台 Mac mini 当「龙虾本体」,这一笔就是硬件成本。 3 月上旬的时候,小红书、闲鱼上到处都是这种帖子: 后来腾讯和几个大公司都在线下免费装龙虾,可以视为 0。 这笔钱对非技术用户是很现实的支出——它不是「运行成本」,而是「入门成本」。 还有一个没说明的是:连卸载龙虾的生意都有人做了,单价 299 一次。 还有一类成本你很容易忽略,但会实实在在占掉你的精力: 调试和维护: 规则跑不稳、网页结构改了、账号登录失效,这些问题都得处理 数据清洗: 抓回来的内容不一定可用,去重、纠错、筛选都需要额外工序 风险兜底: 万一输出有问题,你还是要人来复核,不然出错的不是模型,是你 当你把这三件事想清楚,你就不会被「突然贵了」吓到。 OpenClaw 很强,但它不是魔法,它是一个持续运行的系统。 如果你想让预算可控,一个简单的做法是:先用低频率试跑一周,把「输入长度、输出长度、链路步数」压到最低,再逐步加复杂度。
下一篇
返回文章列表
上一篇